Co naprawdę znaczy „otwarty model"
Firmy nazywają modele otwartymi, publikując same wagi. To przekrój narysowany do połowy - a od aktu o AI ma skutki prawne.
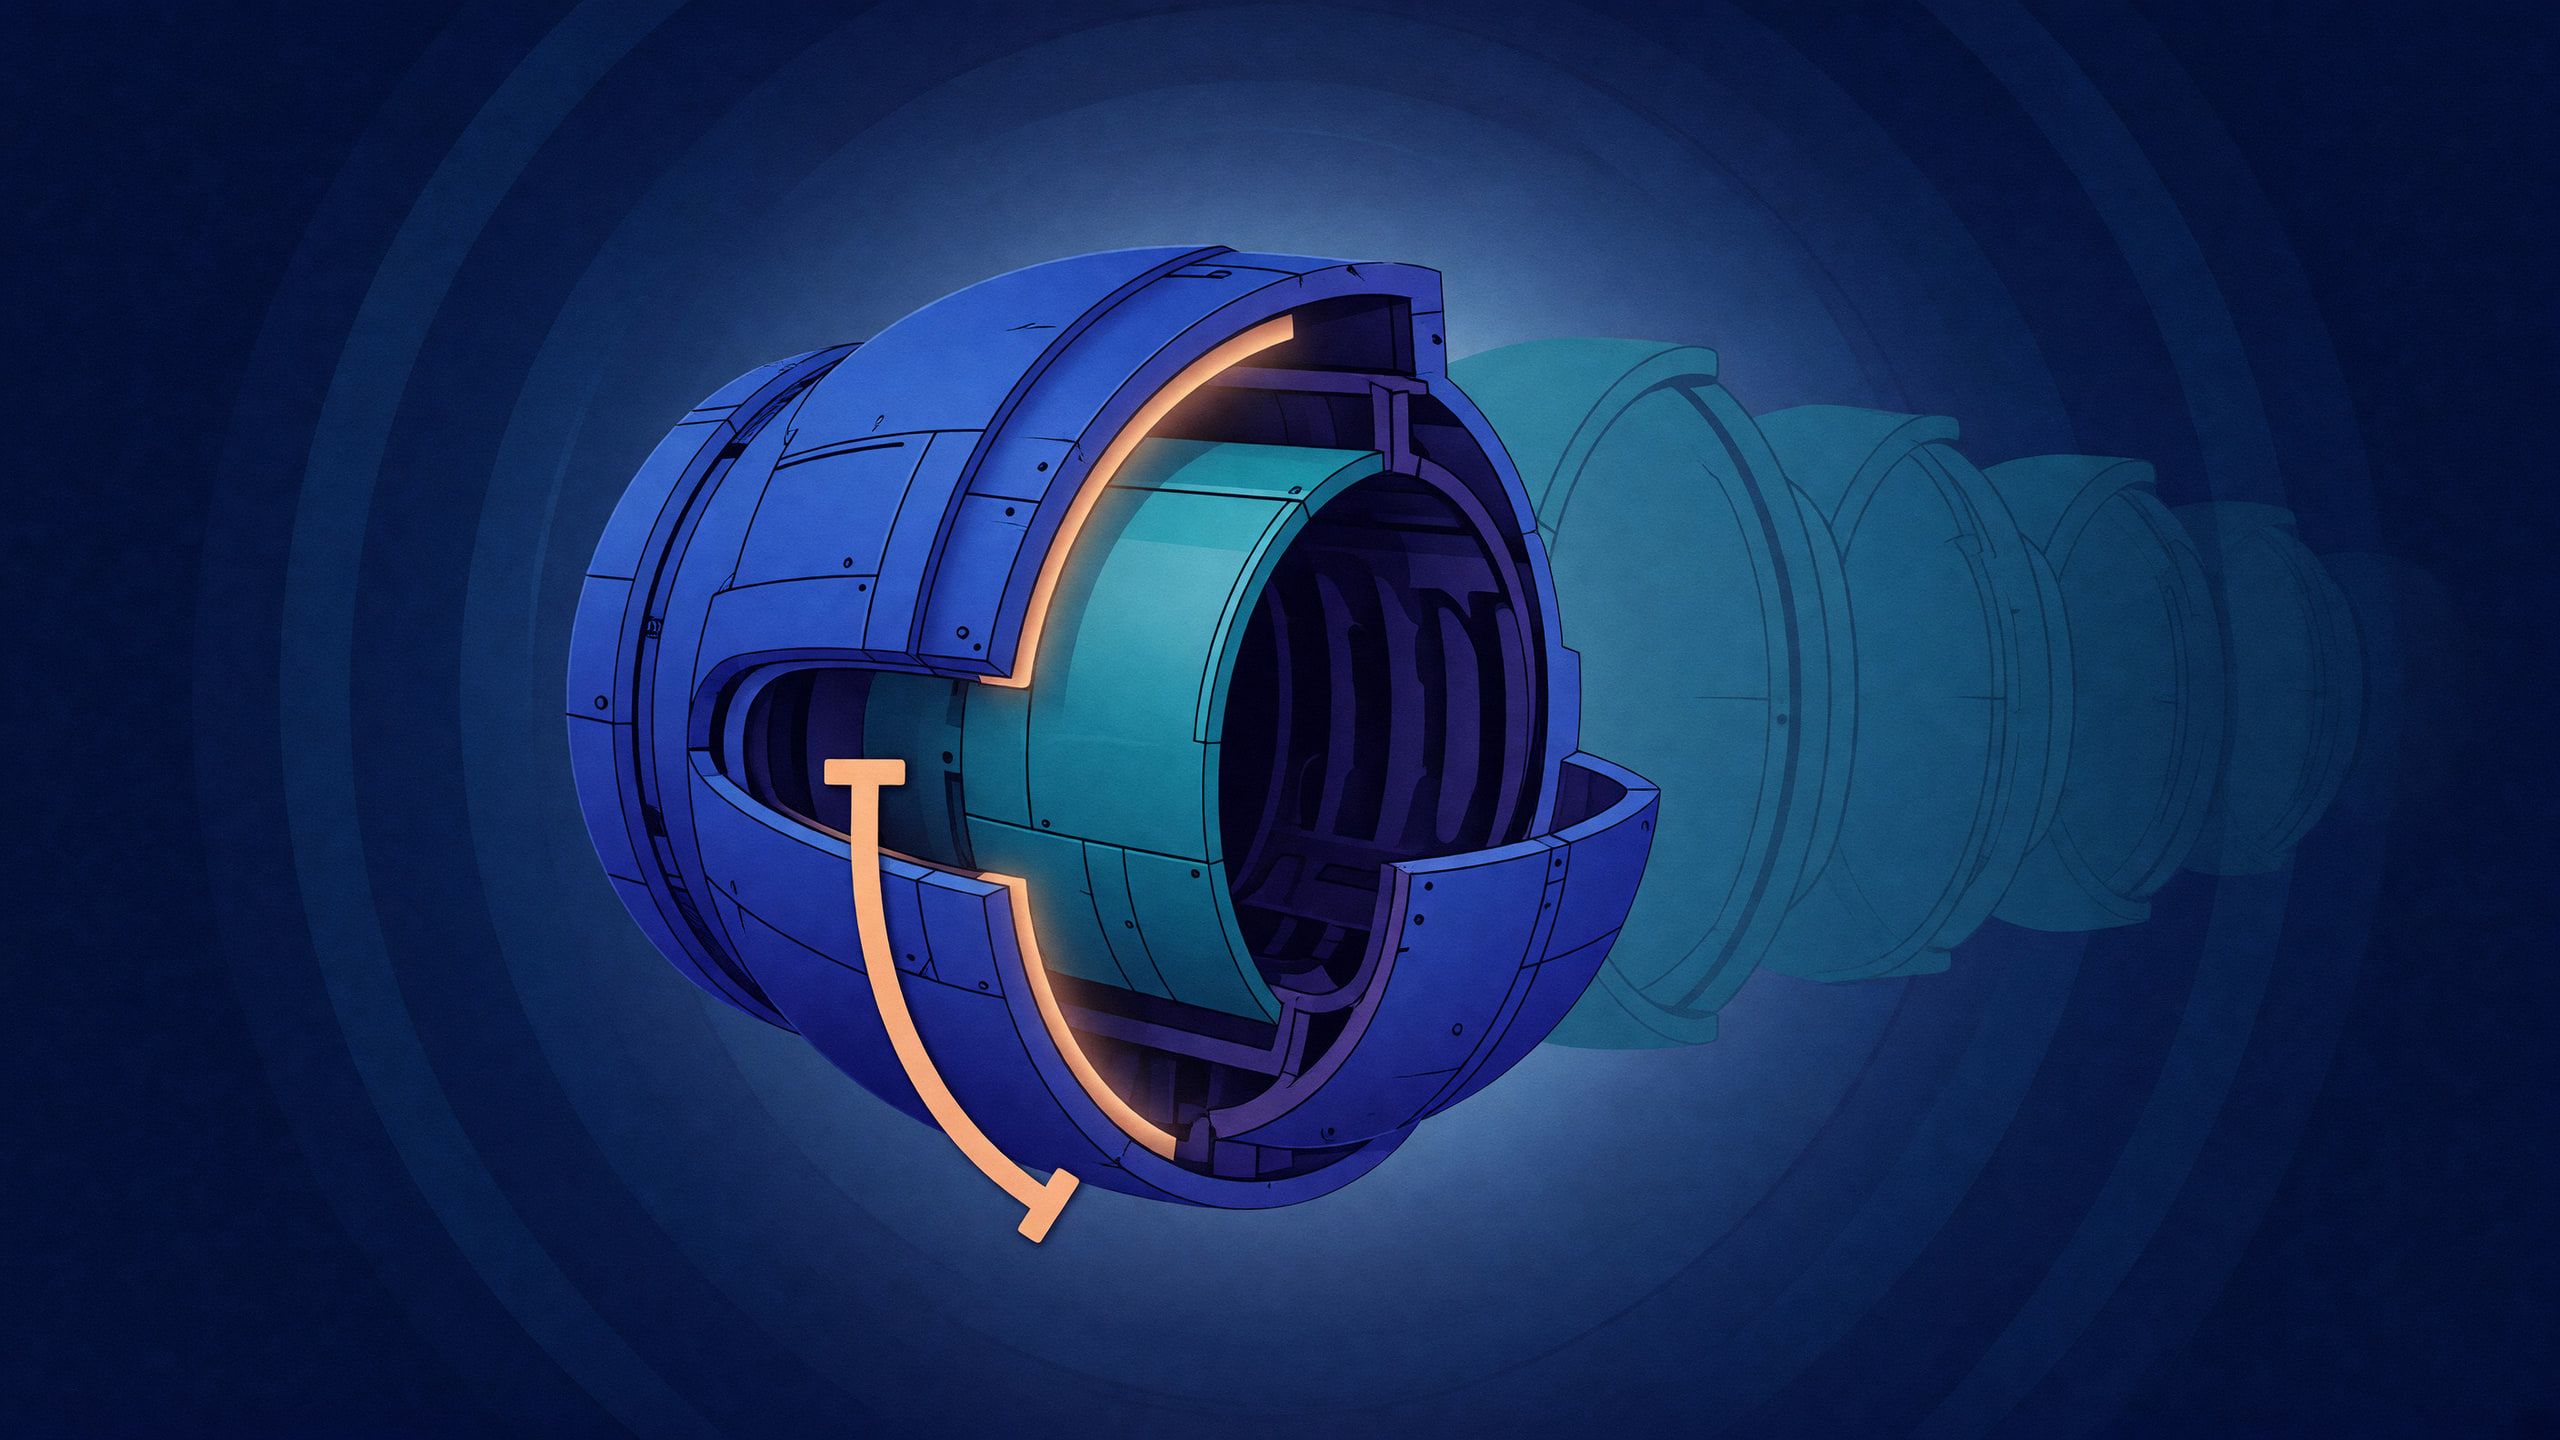
Rycina przedstawia maszynę parową w przekroju: ściana budynku zdjęta, widać kotły, wahacz i każdy przewód. Rysunek techniczny tego rodzaju jest obietnicą - pokazuję ci, jak to działa, sprawdź sam.
Przy modelach językowych ta sama obietnica bywa składana słowem „otwarty”. Warto sprawdzić, ile z przekroju naprawdę narysowano.
Co można udostępnić
Model to nie jeden plik. Na to, żeby ktoś mógł go zrozumieć, powtórzyć albo bezpiecznie użyć, składa się co najmniej sześć rzeczy:
- Wagi - liczby, które są wynikiem treningu.
- Architektura i kod pozwalający model uruchomić.
- Dane treningowe albo przynajmniej ich dokładny opis.
- Kod treningu i parametry procesu.
- Dane z etapu dostrajania: oceny ludzkie, zasady, zbiory instrukcji.
- Dokumentacja: karty modelu, wyniki testów, znane ograniczenia, licencja.
Zdanie „model jest otwarty” pada dziś zwykle wtedy, gdy udostępniono wyłącznie punkt pierwszy - i to na licencji, która ogranicza zastosowania komercyjne albo liczbę użytkowników.
Co pokazał przegląd
W 2024 roku ukazała się praca, która zestawiła modele deklarowane jako otwarte i oceniła każdy według kilkunastu wymiarów: dostępność wag, danych, kodu, dokumentacji, licencji i publikacji naukowej.
Wynik był taki, jak można się spodziewać po każdej dziedzinie bez definicji: rozrzut jest ogromny. Część projektów udostępnia niemal wszystko łącznie z danymi. Część publikuje wagi i nazywa to otwartym źródłem, mimo że nie da się ani powtórzyć treningu, ani sprawdzić, na czym model się uczył.
Autorzy nazwali to zjawisko otwartościowym praniem: korzystaniem z prestiżu wolnego oprogramowania bez ponoszenia jego kosztów.
Ważne zastrzeżenie: to jest ocena według kryteriów zaproponowanych przez autorów, nie pomiar. Ktoś inny mógłby dobrać wymiary inaczej. Sam fakt rozrzutu jest jednak trudny do podważenia.
Co wiemy
- Modele nazywane otwartymi różnią się zakresem udostępnienia o rzędy wielkości.
- Publikacja samych wag nie pozwala powtórzyć treningu ani sprawdzić danych.
- Akt o sztucznej inteligencji traktuje modele na wolnych licencjach odrębnie, więc kwalifikacja ma skutki prawne.
Czego nie wiemy
- Jak dokładnie organy będą kwalifikować modele „częściowo otwarte”. Praktyki jeszcze nie ma.
- Czy udostępnienie danych treningowych jest w ogóle wykonalne przy zbiorach tej wielkości i przy prawie autorskim.
- Czy otwartość zwiększa, czy zmniejsza ryzyko. Argumenty są mocne po obu stronach i żadna nie ma danych.
Dlaczego to nagle stało się kwestią prawną
Bo akt o sztucznej inteligencji przewiduje odrębne traktowanie modeli udostępnianych na wolnych i otwartych licencjach. Część obowiązków dokumentacyjnych i informacyjnych jest przy nich złagodzona, przy zachowaniu wymogów tam, gdzie ryzyko jest systemowe.
Konsekwencja jest prosta i niezamierzona: na nazwaniu modelu otwartym da się zaoszczędzić. Kwalifikacja przestaje być kwestią kultury inżynierskiej, a staje się kwestią zgodności - i pojawia się zachęta, żeby ją naciągać.
To jest ten sam mechanizm, który znamy z innych dziedzin: gdy etykieta zaczyna coś znaczyć w przepisach, natychmiast zaczyna być używana szerzej, niż powinna.
Spór, którego nie da się rozstrzygnąć danymi
Za otwartością. Umożliwia niezależne badania nad bezpieczeństwem, ogranicza zależność od kilku firm, pozwala małym zespołom i uczelniom pracować z tym, co dziś jest poza ich zasięgiem. Bez niej cała interpretowalność zostaje w rękach producentów, którzy oceniają sami siebie.
Przeciw. Udostępnionych wag nie da się wycofać. Zabezpieczenia wbudowane na etapie dostrajania da się usunąć w kilkanaście minut na przeciętnym sprzęcie, a odpowiedzialność rozmywa się na tysiące osób, które model pobrały.
Obie strony mają rację w części sprawdzalnej i żadna nie ma danych o skali. Przy ryzyku biologicznym opisujemy dokładnie ten sam spór, tylko o publikowanie metod - i tam też nie został rozstrzygnięty.
Praktyczna zasada
Przy każdym „otwartym modelu” warto sprawdzić trzy rzeczy - zajmuje to dwie minuty i rozstrzyga więcej niż cały komunikat prasowy:
- Czy licencja jest wolna? Ograniczenie liczby użytkowników albo zakazu zastosowań komercyjnych oznacza, że nie jest.
- Czy wiadomo, na czym model się uczył? Jeśli nie, nie da się ocenić ani uprzedzeń, ani prawa autorskiego, ani zanieczyszczenia zbiorów testowych.
- Czy da się powtórzyć trening? Bez kodu i parametrów odpowiedź brzmi: nie, i wtedy „otwartość” znaczy tyle, co możliwość pobrania gotowego pliku.
Trzy odpowiedzi „nie” opisują sytuację, w której dostajemy działającą maszynę bez rysunku technicznego. Można jej używać. Nie można jej sprawdzić.
Część większego wątku
- Bezpieczeństwo AICztery pytania, które publicystyka zlewa w jedno: jakie cele nadać, jak je przekazać, jak zachować możliwość korekty i jak sprawdzić, czy cokolwiek z tego zadziałało.
Źródła (4)
- Andreas Liesenfeld, Mark Dingemanse, Rethinking open source generative AI: open washing and the EU AI Act, ACM Conference on Fairness, Accountability, and Transparency (FAccT 2024) (2024)
Przegląd modeli deklarowanych jako otwarte, oceniony według kilkunastu wymiarów otwartości. Ocena autorów, nie pomiar.
- Parlament Europejski i Rada, Rozporządzenie (UE) 2024/1689 (akt o sztucznej inteligencji), Dziennik Urzędowy Unii Europejskiej (2024)
Akt prawny. Przewiduje odrębne traktowanie modeli udostępnianych na wolnych i otwartych licencjach.
- Alexandra Sasha Luccioni i in., Estimating the Carbon Footprint of BLOOM, a 176B Parameter Language Model, arXiv (2023)
Przywołane jako przykład modelu, przy którym udostępniono także dane o kosztach i procesie, a nie same wagi.
- Yuntao Bai i in., Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback, arXiv (Anthropic) (2022)
Przywołane dla etapu dostrajania, który przy modelach otwartych bywa nieudokumentowany.
Więcej w dziale Sztuczna inteligencja
Cały dział →
Komentarze
Wczytuję komentarze…